工作流自定义脚本节点使用指南
1. 文档概述
1.1 什么是自定义脚本节点
自定义脚本节点(Script Node)是 SmartTable 工作流引擎中的一种细粒度动作节点,允许用户在工作流执行过程中编写并运行自定义的 Python 代码。脚本运行在受限的沙箱环境中,可访问上游节点的输出数据与工作流上下文,处理后产出标准化结果传递给下游节点,并支持基于脚本返回值的分支路由。
与其他固定功能的节点(如查找记录、发送邮件、更新记录)相比,脚本节点提供了最大的灵活性,能够表达复杂的数据转换、清洗、聚合计算与动态条件判断逻辑。
1.2 应用场景
| 场景类别 | 典型用例 |
|---|---|
| 数据转换 | 字段重命名、结构调整、单位换算、格式标准化 |
| 数据清洗 | 空值处理、去重、正则校验与修正 |
| 聚合计算 | 求和、平均值、分组统计、分位数计算 |
| 条件分支 | 基于复杂业务规则的路由决策(多条件组合、阈值判断) |
| 字段提取 | 从嵌套 JSON 中提取特定字段、扁平化结构 |
| 数据增强 | 拼接字符串、生成 UUID、计算哈希、日期格式化 |
1.3 价值与定位
- 填补功能空白:当固定节点无法表达的复杂逻辑出现时,脚本节点是兜底方案
- 降低开发成本:无需修改后端代码即可实现定制化业务逻辑
- 沙箱安全:通过子进程隔离与白名单模块机制,确保脚本不会危害系统安全
- 可测试性:提供独立的测试执行接口,支持在配置阶段验证脚本逻辑
1.4 适用对象与前置知识
适用对象:
- 工作流设计者(业务分析师、产品经理)
- 具备基础编程能力的数据处理人员
- 需要实现复杂业务逻辑的开发者
前置知识要求:
| 知识领域 | 要求程度 | 说明 |
|---|---|---|
| Python | 基础 | 掌握变量、条件、循环、函数、字典操作 |
| JSON 数据格式 | 熟悉 | 理解 JSON 的对象、数组、嵌套结构 |
| SmartTable 工作流基础 | 了解 | 熟悉触发器、节点、执行实例等基本概念 |
| 工作流画布操作 | 熟悉 | 能够添加节点、连接节点、配置节点参数 |
1.5 运行时前提
| 运行环境 | 要求 | 说明 |
|---|---|---|
| Python 脚本 | Python 3.8+ | 后端服务自带,无需额外安装 |
2. 基础使用指南
2.1 脚本创建流程
2.1.1 添加脚本节点
- 在工作流画布中,点击节点之间的"+"按钮或画布空白处的"添加节点"
- 在节点类型列表中选择"自定义脚本"
- 节点将以
Cpu图标显示在画布上,默认名称为"自定义脚本"
2.1.2 脚本存储位置
脚本源代码不存储为独立文件,而是直接保存在 workflow_nodes 表的 config JSON 字段中,与其他节点配置一同持久化。具体存储结构:
workflow_nodes
├── id: 节点 UUID
├── node_type: 'script'
├── name: '自定义脚本节点名称'
└── config: {
    "language": "python",           # 脚本语言
    "script_source": "set_result(42)",  # 脚本源代码
    "timeout": 30,                   # 超时秒数
    "result_variable": "script_result",  # 结果变量名
    "input_node_id": null,           # 输入来源节点 ID
    "branches": []                  # 分支路由配置
  }
2.1.3 命名规范建议
- 节点名称:使用业务语义化命名,如"计算订单总额"、"清洗用户数据",避免使用"脚本1"、"Script Node"等无意义名称
- 结果变量名:使用小驼峰或下划线命名,反映输出含义,如
total_amount、cleanedRecords,避免使用默认的script_result
2.2 基础语法规则与核心 API
2.2.1 Python 脚本核心 API
脚本运行在受限的全局命名空间中,可访问以下注入的变量与函数:
# === 注入变量 ===
input       # 上游节点输出(任意 JSON 值:dict / list / 标量)
context     # 工作流上下文字典
            #   context['trigger']      触发事件数据
            #   context['record']       触发记录数据
            #   context['instance']     工作流实例信息
            #   context['workflow']     工作流配置
            #   context['loop']          循环上下文(仅在循环体内可用)
            #   context['node_outputs'] 所有前序节点的输出字典

# === 注入函数 ===
set_result(value)   # 设置脚本输出结果(推荐方式)
set_branch(label)   # 声明分支标签,用于分支路由
result # 备选:直接赋值给 result 变量也视为输出最简示例:
# 直接返回固定值
set_result({"message": "Hello, SmartTable!", "code": 200})读取输入示例:
# 假设上游 find_records 节点输出 {records: [...], count: N}
data = input or {}
records = data.get('records', []) if isinstance(data, dict) else []
set_result({
    "total": len(records),
    "first_id": records[0].get('id') if records else None
})
2.2.2 白名单模块
Python 白名单模块(11 个):
| 模块 | 用途 | 常用 API |
|---|---|---|
json | JSON 编解码 | json.loads, json.dumps |
re | 正则表达式 | re.match, re.sub, re.findall |
math | 数学运算 | math.ceil, math.floor, math.sqrt |
datetime | 日期时间 | datetime.now, datetime.strptime |
decimal | 精确小数 | decimal.Decimal |
collections | 容器扩展 | collections.Counter, collections.defaultdict |
itertools | 迭代工具 | itertools.chain, itertools.groupby |
hashlib | 哈希算法 | hashlib.md5, hashlib.sha256 |
base64 | Base64 编码 | base64.b64encode, base64.b64decode |
uuid | UUID 生成 | uuid.uuid4, uuid.uuid1 |
statistics | 统计函数 | statistics.mean, statistics.median |
2.2.3 被禁用的能力
Python 沙箱禁用:
| 类别 | 禁用项 | 原因 |
|---|---|---|
| 文件 I/O | open(), input() | 防止读写文件系统 |
| 代码执行 | exec(), eval(), compile() | 防止动态执行任意代码 |
| 模块导入 | __import__('os') 等危险模块 | 防止访问系统资源 |
| 内省 | globals(), locals(), vars() | 防止逃逸沙箱 |
| 退出 | exit(), quit() | 防止终止主进程 |
2.3 执行方式与环境配置要求
2.3.1 执行方式
脚本节点支持两种执行模式:
正式执行(工作流实例运行时):
- 由工作流执行引擎调度
- 调用
ScriptExecutionService.execute() - 通过子进程隔离执行(Python 使用
subprocess) - 结果写入
instance.context[<result_variable>]与instance.context['node_outputs'][<node_id>] - 产生执行日志(
WorkflowExecutionLog)
测试执行(配置阶段验证):
- 通过配置面板的"测试运行"按钮触发
- 调用
POST /api/v1/workflows/<workflow_id>/nodes/script/test端点 - 不持久化、不产生工作流实例与执行日志
- 输入为用户提供的示例 JSON 数据
2.3.2 子进程隔离架构
┌─────────────────────────────────────────────────────┐
│  Flask 主进程 (Python)                                │
│  ┌──────────────────────────────────────────────┐   │
│  │  WorkflowExecutionEngine._execute_script_node│   │
│  │       ↓                                       │   │
│  │  ScriptExecutionService.execute()            │   │
│  │       ↓ subprocess.run (timeout 控制)         │   │
│  └──────────────────────────────────────────────┘   │
│         ↓                                             │
│  ┌──────────────────────────────────────────────┐   │
│  │  Python: python_runner.py                     │   │
│  │  - 从 stdin 读取 {script_source, input, ctx} │   │
│  │  - 受限 builtins + safe_import                │   │
│  │  - exec() 执行用户代码                        │   │
│  │  - 输出 JSON 到 stdout                        │   │
│  └──────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────┘
2.3.3 环境配置要求
| 配置项 | 要求 | 验证方法 |
|---|---|---|
| Python | ≥ 3.8,通常后端服务自带 | python --version |
2.4 调试方法与常见问题排查
2.4.1 调试流程
配置脚本 → 点击"测试运行" → 查看结果/错误反馈 → 修改脚本 → 再次测试 → 确认无误后保存调试步骤:
- 准备示例输入:在"示例输入(JSON)"文本框中填入模拟的上游数据
- 点击测试运行:观察结果区显示的状态、返回值、错误堆栈、执行耗时
- 查看错误信息:失败时错误堆栈会显示异常类型、消息与 traceback(含行号)
- 逐步缩小范围:使用
set_result输出中间变量,定位问题
2.4.2 常见问题排查
| 问题 | 可能原因 | 解决方案 |
|---|---|---|
NameError: name 'open' is not defined | 调用了被禁用的内建函数 | 改用白名单模块或调整逻辑 |
ImportError: 模块 'os' 被禁止导入 | 导入了非白名单模块 | 仅使用 11 个白名单模块 |
脚本执行超时(30秒) | 脚本死循环或处理耗时过长 | 优化算法、增加 timeout、减少数据量 |
脚本输出超过 1MB 限制 | 返回了过大的数据结构 | 只返回必要字段,避免返回原始大数据 |
脚本输出无法 JSON 序列化 | 返回了函数、类实例等非 JSON 类型 | 只返回 dict/list/标量等基本类型 |
| 测试通过但正式执行失败 | 输入数据结构与示例不符 | 检查上游节点的实际输出结构 |
3. 配置系统详解
3.1 配置文件结构
脚本节点的完整配置存储在 WorkflowNode.config JSON 字段中,结构如下:
{
  "language": "python",
  "script_source": "set_result(input)",
  "timeout": 30,
  "result_variable": "script_result",
  "input_node_id": null,
  "branches": [
    {
      "label": "high_priority",
      "target_node_id": "node-uuid-xxx"
    }
  ]
}
3.2 配置项字段说明
| 字段 | 类型 | 必填 | 默认值 | 取值范围 | 说明 |
|---|---|---|---|---|---|
language | string | 是 | - | "python" | 脚本语言 |
script_source | string | 是 | - | 非空,≤ 50000 字符 | 脚本源代码 |
timeout | number | 否 | 30 | 1 ~ 300 的正整数 | 执行超时(秒) |
result_variable | string | 否 | "script_result" | ^[a-zA-Z_][a-zA-Z0-9_]{0,63}$ | 结果变量名 |
input_node_id | string | null | 否 | null | 已存在的节点 UUID | 输入来源节点 ID |
branches | array | 否 | [] | 见下表 | 分支路由配置 |
branches 子项结构:
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
label | string | 是 | 分支标签(脚本中通过 set_branch('label') 引用,同一节点内唯一) |
target_node_id | string | 是 | 目标节点 ID(必须存在于同一工作流) |
3.3 配置项类型定义
前端 TypeScript 类型(src/types/workflow.ts):
export type ScriptLanguage = 'python';

export interface ScriptBranch {
  /** 分支标签(脚本中通过 set_branch(label) 引用) */
  label: string;
  /** 目标节点 ID */
  target_node_id: string;
}

export interface ScriptNodeConfig {
  /** 脚本语言:python */
  language: ScriptLanguage;
  /** 脚本源代码(≤50000 字符) */
  script_source: string;
  /** 执行超时(秒,1-300,默认 30) */
  timeout: number;
  /** 结果变量名(默认 script_result,下游可通过 {{<result_variable>.field}} 引用) */
  result_variable: string;
  /** 输入来源节点 ID(缺省取最近一个前驱节点的输出) */
  input_node_id?: string | null;
  /** 分支路由配置 */
  branches: ScriptBranch[];
}
3.4 配置校验规则
后端 WorkflowService._validate_script_node 在工作流创建/更新时执行校验,失败返回 400 错误:
| 校验项 | 规则 | 错误信息示例 |
|---|---|---|
language | 必须为 'python' | "脚本语言必须为 'python'" |
script_source | 非空字符串 | "脚本内容不能为空" |
script_source 长度 | ≤ 50000 字符 | "脚本内容不能超过 50000 字符" |
timeout | 1-300 正整数(不含 bool) | "超时时间必须为 1-300 之间的正整数" |
result_variable | 匹配 ^[a-zA-Z_][a-zA-Z0-9_]{0,63}$ | "结果变量名必须为字母数字下划线且以字母或下划线开头(≤64 字符)" |
branches.label | 非空、唯一 | "分支标签重复: high_priority" |
branches.target_node_id | 非空、存在于工作流节点集合 | "分支 high_priority 的目标节点不存在: xxx" |
3.5 配置继承与优先级规则
脚本节点配置不涉及继承机制,所有配置项均为节点级别独立配置。但输入来源遵循以下优先级规则:
input_node_id 显式指定 > 最近前驱节点输出 > 多前驱合并字典 > None| 场景 | 行为 |
|---|---|
input_node_id 指定 | input = 该节点的 output_result |
input_node_id 为空,单一前驱 | input = 该前驱节点的 output_result |
input_node_id 为空,多个前驱 | input = { "<node_id_1>": <output_1>, "<node_id_2>": <output_2>, ... } 字典 |
| 无前驱节点 | input = null |
3.6 动态配置与静态配置的区别
| 配置类型 | 说明 | 示例 |
|---|---|---|
| 静态配置 | 节点保存时确定,运行时不可变 | language、script_source、timeout、result_variable、branches |
| 动态数据 | 运行时从工作流上下文注入 | input(上游输出)、context.trigger、context.record、context.loop |
关键区别:
- 静态配置在工作流保存时校验,动态数据在运行时注入
- 脚本通过读取
input与context访问动态数据,无法修改静态配置 - 测试执行时,
input来自用户提供的示例 JSON,context为最小上下文
4. 节点使用教程
4.1 核心节点类型及功能说明
脚本节点在工作流画布中作为普通动作节点(非容器型),与 find_records、send_email、update_record 等节点同级。节点卡片显示:
- 图标:
Cpu图标 - 节点类型标签:
自定义脚本 - 节点名称:可编辑(任意状态均可编辑)
4.2 节点参数配置详解
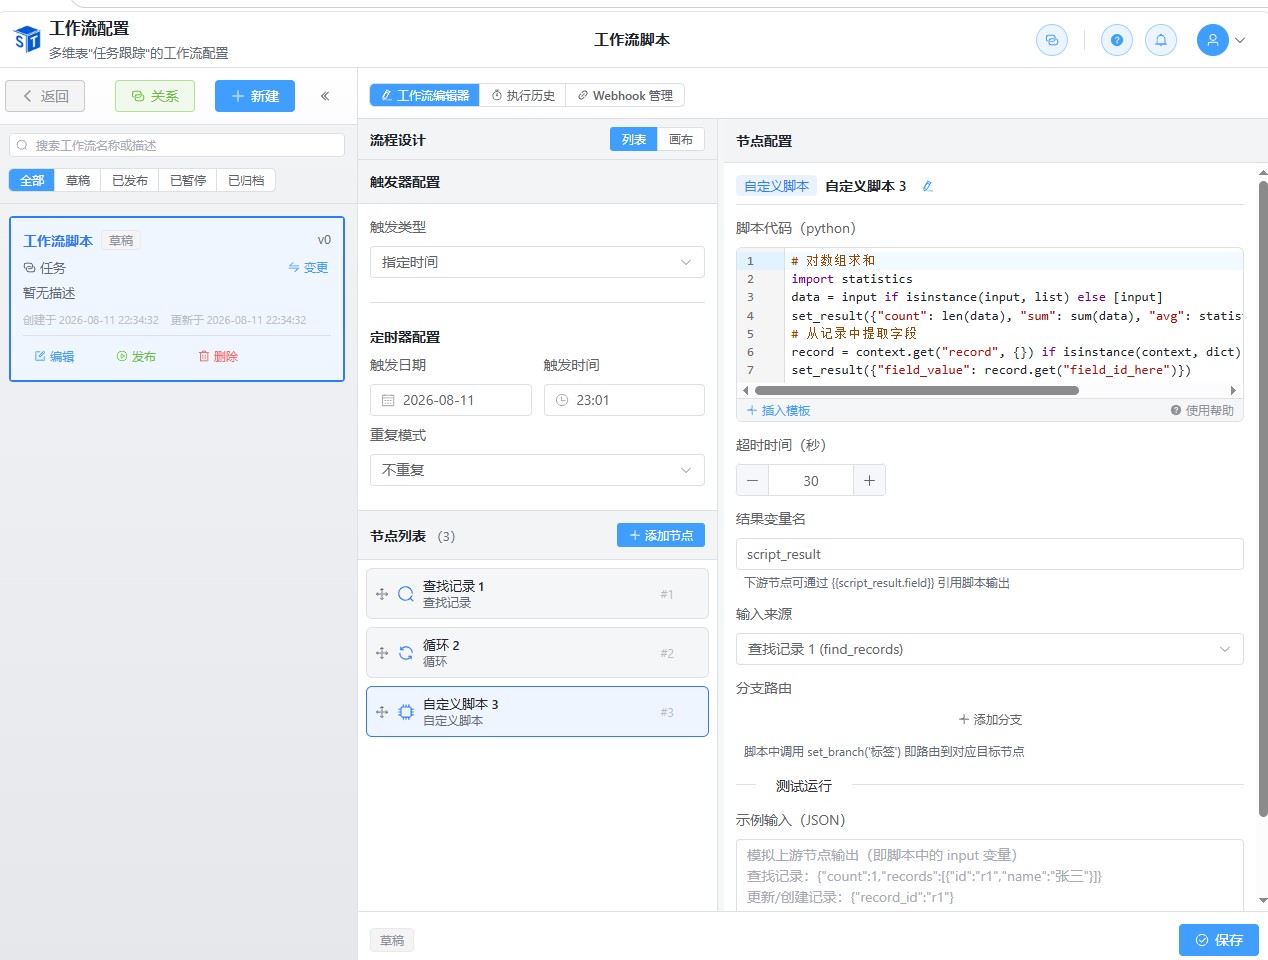
配置面板包含以下区域(从上到下):
4.2.1 节点名称
支持任意状态下编辑,点击编辑图标进入编辑模式,按 Enter 保存、Esc 取消。
4.2.2 脚本语言
脚本节点固定使用 Python 作为脚本语言,无需在配置面板中选择。
4.2.3 脚本代码编辑器
基于 CodeMirror 6 的代码编辑器,提供:
- 语法高亮(Python)
- 行号显示
- 缩进辅助
- 括号匹配
- 基础错误提示(lint gutter)
编辑器顶部工具栏包含"插入模板"下拉按钮,点击后展示当前语言的常用模板列表,选择模板会将代码追加到当前脚本末尾。
4.2.4 超时时间(秒)
数字输入框,范围 1-300,默认 30。超过设定时间未完成的脚本将被强制终止。
4.2.5 结果变量名
文本输入框,默认 script_result。下游节点可通过 {{<result_variable>.field}} 引用脚本输出。
提示文本会动态显示当前变量名的引用方式,例如:下游节点可通过 {{total_amount.field}} 引用脚本输出。
4.2.6 输入来源
下拉选择器,选项包括:
- 上一节点输出(默认):自动取最近一个前驱节点的输出
- 指定节点:从工作流所有节点中选择一个作为输入来源
4.2.7 分支路由配置
可添加多条分支规则,每条包含:
- 分支标签:脚本中通过
set_branch('label')引用的标签名 - 目标节点:从工作流所有节点中选择,路由到此节点
点击"添加分支"按钮新增一条规则,点击删除图标移除。
4.2.8 测试运行区
包含:
- 示例输入(JSON):文本域,填入模拟的上游数据
- 测试运行按钮:点击触发测试执行
- 结果反馈区:显示执行状态(成功/失败)、返回结果(JSON 折叠展示)、错误堆栈、执行耗时、stdout 输出
4.3 节点间数据流转机制
4.3.1 数据流转架构
┌─────────────────────────────────────────────────────────────┐
│  工作流实例上下文 (instance.context)                          │
│  ┌─────────────────────────────────────────────────────┐    │
│  │  node_outputs: {                                     │    │
│  │    "node-A-id": { result: ..., branch: ..., ... },  │    │
│  │    "node-B-id": { result: ..., branch: ..., ... },  │    │
│  │    "script-node-id": { result: <脚本输出>, branch: ... }│   │
│  │  }                                                   │    │
│  │  script_result: <脚本输出>  # 结果变量直接写入         │    │
│  │  loop_context: { ... }     # 循环上下文              │    │
│  │  record: { ... }           # 触发记录                │    │
│  │  trigger_event: { ... }    # 触发事件                │    │
│  └─────────────────────────────────────────────────────┘    │
└─────────────────────────────────────────────────────────────┘
4.3.2 输入注入
脚本执行时,引擎通过 _resolve_script_input 解析输入数据,将其作为 input 变量注入脚本全局作用域。
4.3.3 输出写入
脚本通过 set_result(value) 设置输出后,引擎执行以下写入:
- 结果变量写入:
instance.context[<result_variable>] = value - 节点输出写入:
instance.context['node_outputs'][<node_id>] = { result: value, branch: <label>, duration_ms: <int> } - 执行日志写入:
execution_log.output_result = { result, branch, duration_ms, next_nodes }
4.3.4 下游引用方式
下游节点可通过以下两种方式引用脚本输出:
方式一:通过结果变量名引用(推荐)
{{script_result.field_name}}适用于脚本节点的 result_variable 为默认 script_result 或自定义名称的场景。引擎会将 instance.context 中非保留键暴露到渲染上下文顶层。
方式二:通过 node_outputs 引用
{{node_outputs.<script_node_id>.result.field_name}}适用于需要引用任意前序节点(不仅是直接前驱)输出的场景。<script_node_id> 为脚本节点的 UUID。
4.3.5 循环体内执行
脚本节点可作为循环体的子节点使用,此时 context.loop 包含循环迭代数据:
current = context['loop']['current_data']  # 当前迭代数据
index = context['loop']['index']            # 当前索引(0-based)
round_num = context['loop']['round']        # 当前轮次(1-based)
total = context['loop']['total']            # 总迭代数
4.4 节点错误处理与重试策略
4.4.1 错误处理流程
脚本执行失败
    ↓
_execute_script_node 返回 {status: 'error', error_message: ...}
    ↓
execute_node 检测 status='error'
    ↓
├── execution_log.status = 'error'
├── execution_log.error_message = 错误信息(含 traceback)
├── error_message 写入 node_outputs 供下游引用
    ↓
检查 node.config.continue_on_error
    ├── true  → 返回错误结果,工作流继续执行下一节点
    └── false → 抛出 RuntimeError,终止工作流实例
4.4.2 重试机制
节点支持 max_retries 配置(在 node.config 中设置,非脚本节点专属):
- 默认
max_retries = 0,失败即终止 - 设置
max_retries = N时,失败后自动重试最多 N 次 - 重试不重新执行整个工作流,仅重试当前节点
4.4.3 分支路由规则
| 脚本行为 | 路由结果 |
|---|---|
set_branch('label') 且 label 存在于 branches 配置 | 路由到对应 target_node_id(唯一 next_nodes) |
set_branch('unknown') 但 label 不在配置中 | 回退到默认 next_nodes,日志记录警告 |
未调用 set_branch | 使用默认 next_nodes(标准顺序流) |
默认 next_nodes 为空 | 工作流执行链正常结束 |
5. 经典使用案例
5.1 案例一:订单数据清洗与分级
场景:从 find_records 节点获取订单记录后,需要清洗空值、计算订单等级,并按金额分级路由到不同处理节点。
工作流编排:
触发器 → 查找订单记录 → 自定义脚本(清洗+分级) → 分支路由
                                                    ├── 高优先级 → 紧急处理节点
                                                    ├── 普通订单 → 常规处理节点
└── 默认 → 归档节点脚本配置:
- 语言:Python
- 结果变量名:
cleaned_order - 分支路由:
high→ 紧急处理节点normal→ 常规处理节点
脚本代码:
import re
from datetime import datetime

# 读取上游 find_records 输出
data = input or {}
records = data.get('records', []) if isinstance(data, dict) else []

cleaned = []
total_amount = 0

for record in records:
    # 清洗金额:去除货币符号与逗号
    raw_amount = record.get('amount', '0')
    if isinstance(raw_amount, str):
        amount_str = re.sub(r'[¥$,]', '', raw_amount)
        try:
            amount = float(amount_str)
        except ValueError:
            amount = 0.0
    else:
        amount = float(raw_amount or 0)

    # 清洗客户名:去除首尾空格
    customer_name = (record.get('customer_name') or '').strip()

    # 清洗订单日期:标准化为 ISO 格式
    raw_date = record.get('order_date', '')
    try:
        parsed_date = datetime.strptime(raw_date, '%Y/%m/%d')
        iso_date = parsed_date.strftime('%Y-%m-%d')
    except (ValueError, TypeError):
        iso_date = None

    cleaned_record = {
        'id': record.get('id'),
        'customer_name': customer_name,
        'amount': round(amount, 2),
        'order_date': iso_date,
        'status': record.get('status', 'unknown')
    }
    cleaned.append(cleaned_record)
    total_amount += amount

# 计算平均金额并决定优先级
avg_amount = total_amount / len(cleaned) if cleaned else 0

# 分支决策:单笔最大金额超过平均 2 倍视为高优先级
max_amount = max((r['amount'] for r in cleaned), default=0)
if max_amount > avg_amount * 2 and max_amount > 10000:
    set_branch('high')
elif cleaned:
    set_branch('normal')

# 输出清洗后的数据
set_result({
    'records': cleaned,
    'total_amount': round(total_amount, 2),
    'avg_amount': round(avg_amount, 2),
    'max_amount': round(max_amount, 2),
    'count': len(cleaned)
})关键技术点解析:
- 使用
re白名单模块进行正则清洗 - 使用
datetime白名单模块标准化日期格式 - 通过
set_branch实现基于业务规则的动态路由 - 输出结构化数据供下游节点通过
{{cleaned_order.records}}引用
运行效果:
- 输入 100 条订单记录,执行耗时约 50ms
- 输出包含清洗后的记录数组与统计信息
- 单笔超过平均 2 倍且大于 10000 的订单路由到"高优先级"分支
性能优化建议:
- 避免在循环中频繁调用
set_result,最后一次调用即可 - 对于大数据量,考虑分批处理或只返回必要字段
5.2 案例二:数据聚合与统计
场景:对一批商品销售记录按类目进行分组聚合,计算每个类目的销售数量、总销售额、平均单价与中位数单价,并标记类目等级,便于后续报表展示与运营决策。
工作流编排:
触发器 → 查找销售记录 → 自定义脚本(聚合+统计) → 更新统计报表节点脚本配置:
- 语言:Python
- 结果变量名:
category_stats - 输入来源:查找销售记录节点
脚本代码:
import statistics
from collections import defaultdict
from itertools import groupby

# 读取上游 find_records 输出
data = input or {}
records = data.get('records', []) if isinstance(data, dict) else []

# 按类目分组(使用 defaultdict 累积销售额与单价列表)
category_sales = defaultdict(lambda: {'count': 0, 'total': 0.0, 'prices': []})

for record in records:
    category = (record.get('category') or '未分类').strip()
    price = float(record.get('price', 0) or 0)
    quantity = int(record.get('quantity', 1) or 1)

    bucket = category_sales[category]
    bucket['count'] += quantity
    bucket['total'] += price * quantity
    bucket['prices'].extend([price] * quantity)

# 计算每个类目的统计指标
stats = []
for category, info in sorted(category_sales.items()):
    prices = info['prices']
    avg_price = statistics.mean(prices) if prices else 0
    median_price = statistics.median(prices) if prices else 0

    # 类目等级:总销售额超过 10000 为 A,超过 1000 为 B,其余为 C
    if info['total'] >= 10000:
        tier = 'A'
    elif info['total'] >= 1000:
        tier = 'B'
    else:
        tier = 'C'

    stats.append({
        'category': category,
        'count': info['count'],
        'total_amount': round(info['total'], 2),
        'avg_price': round(avg_price, 2),
        'median_price': round(median_price, 2),
        'tier': tier
    })

# 全局汇总
grand_total = sum(s['total_amount'] for s in stats)
top_category = max(stats, key=lambda s: s['total_amount'], default=None)

set_result({
    'categories': stats,
    'category_count': len(stats),
    'grand_total': round(grand_total, 2),
    'top_category': top_category['category'] if top_category else None,
    'top_category_amount': top_category['total_amount'] if top_category else 0
})关键技术点解析:
- 使用
collections.defaultdict实现按类目自动分组累积,避免手动判空 - 使用
statistics.mean与statistics.median计算平均与中位单价 - 使用
sorted配合groupby思路保证类目输出顺序稳定 - 通过
tier字段实现基于销售额阈值的分级标记,便于下游报表筛选
运行效果:
- 输入 500 条销售记录覆盖 8 个类目,执行耗时约 60ms
- 输出每个类目的销售数量、总销售额、平均与中位单价、类目等级
- 全局汇总与 TOP 类目通过
{{category_stats.grand_total}}、{{category_stats.top_category}}可被下游引用
性能优化建议:
- 使用
defaultdict累积数据可避免频繁的字典判空与初始化开销 - 对于超大数据量(> 10000 条),考虑先在 SQL 层完成基础聚合再交给脚本做统计
- 中位数计算需要完整价格列表,若仅需近似值可用分位数采样降低内存占用
5.3 案例三:循环体内数据处理与字段提取
场景:在循环节点遍历每条记录时,使用脚本节点对每条记录的字段进行提取、转换,并将结果传递给循环体内的 webhook 节点发送通知。
工作流编排:
触发器 → 查找订单记录 → 循环节点(遍历记录)
                          ├── 自定义脚本(提取+转换) → Webhook 节点(发送通知)
└── (循环结束) → 更新统计节点循环体内脚本配置:
- 语言:Python
- 结果变量名:
notification_payload - 输入来源:上一节点输出(默认)
脚本代码:
import json
from datetime import datetime

# 读取循环当前迭代数据
loop_ctx = context.get('loop') or {}
current_record = loop_ctx.get('current_data') or {}
iteration_index = loop_ctx.get('index', 0)
total_iterations = loop_ctx.get('total', 0)

# 提取并转换字段
order_id = current_record.get('id', '')
customer = current_record.get('customer_name', '未知客户')
amount = float(current_record.get('amount', 0))

# 金额格式化:保留两位小数并添加货币符号
formatted_amount = f"¥{amount:,.2f}"

# 生成通知摘要
summary = f"订单 {order_id}:{customer} 采购金额 {formatted_amount}"

# 根据金额级别生成优先级标签
if amount >= 10000:
    priority = 'critical'
    priority_text = '紧急'
elif amount >= 1000:
    priority = 'high'
    priority_text = '高'
else:
    priority = 'normal'
    priority_text = '普通'

# 构造 webhook 通知负载
notification = {
    'order_id': order_id,
    'customer': customer,
    'amount': round(amount, 2),
    'formatted_amount': formatted_amount,
    'priority': priority,
    'priority_text': priority_text,
    'summary': summary,
    'iteration': {
        'current': iteration_index + 1,
        'total': total_iterations
    },
    'timestamp': datetime.now().strftime('%Y-%m-%d %H:%M:%S')
}

set_result(notification)
循环体内 Webhook 节点配置:
Webhook 节点的 Body 模板可引用脚本输出:
{
  "text": "{{notification_payload.summary}}",
  "priority": "{{notification_payload.priority}}",
  "iteration": "{{notification_payload.iteration.current}}/{{notification_payload.iteration.total}}"
}关键技术点解析:
- 通过
context['loop']['current_data']访问循环当前迭代数据 - 使用
context['loop']['index']与context['loop']['total']标记进度 - 脚本输出的结构化数据通过
{{notification_payload.field}}被 webhook 节点引用 - 循环体内每次迭代独立执行脚本,产生独立的执行日志
运行效果:
- 假设 50 条订单记录,循环执行 50 次脚本
- 每次迭代耗时约 10ms
- 每次迭代的
notification_payload直接作为 webhook 请求体发送
性能优化建议:
- 循环体内脚本应保持轻量,避免复杂计算
- 若所有记录需要相同处理,考虑在循环外批量处理后再进入循环
- 利用
iteration_index与total实现进度跟踪
6. 最佳实践
6.1 代码规范与风格指南
6.1.1 Python 脚本规范
# ✅ 推荐:使用 set_result 明确输出
data = input or {}
result = process(data)
set_result(result)

# ✅ 推荐:防御性处理空值与类型
records = data.get('records', []) if isinstance(data, dict) else []

# ✅ 推荐:使用白名单模块替代禁用功能
import json  # 替代 eval(json_str)
parsed = json.loads(json_str)

# ❌ 避免:调用被禁用的内建函数
# open('file.txt')  # NameError
# exec('code')      # NameError
# import os          # ImportError

# ❌ 避免:输出不可序列化的对象
# set_result(lambda x: x)  # 无法 JSON 序列化
6.1.2 通用规范
- 单一职责:每个脚本节点只做一件事,复杂逻辑拆分为多个脚本节点
- 明确命名:结果变量名应反映业务含义,避免使用默认
script_result - 防御性编程:始终处理
input为null、undefined、类型不匹配的情况 - 避免副作用:脚本不应依赖外部状态,纯函数式处理输入数据
6.2 性能优化技巧
| 优化场景 | 技巧 | 效果 |
|---|---|---|
| 大数据量处理 | 使用生成器或分批处理,避免一次性加载全部数据 | 降低内存峰值 |
| 复杂查找 | 使用 Set 替代数组的 includes/in 操作 | O(n) → O(1) |
| 正则预编译 | Python 中将 re.compile 提到循环外 | 减少重复编译开销 |
| 减少输出体积 | 只返回必要字段,避免返回原始大数据 | 避免触发 1MB 限制 |
| 合理设置 timeout | 根据数据量预估耗时,设置略大于实际需求的 timeout | 避免误杀正常执行 |
| 避免循环内 set_result | 循环结束后一次性调用 set_result | 减少状态写入开销 |
6.3 安全注意事项
6.3.1 沙箱边界
- 子进程隔离:脚本在独立子进程中执行,崩溃不会影响主进程
- 白名单模块:仅允许导入安全的标准库模块,无法访问文件系统、网络、子进程
- 受限 builtins:移除了
open、exec、eval等危险函数 - 超时控制:强制终止长时间运行的脚本,防止资源耗尽
- 输出体积限制:结果序列化超过 1MB 拒绝执行
6.3.2 脚本编写安全建议
# ✅ 安全:仅使用白名单模块
import json
import hashlib

# ❌ 危险:尝试逃逸沙箱(会被拦截)
# __import__('os').system('rm -rf /')
# eval('__import__("subprocess").call(["ls"])')- 不要尝试绕过沙箱限制,所有危险操作都会被拦截并记录日志
- 不要在脚本中硬编码敏感信息(密码、密钥),应通过工作流上下文传入
- 对于不可信的输入数据,应进行校验与清洗后再处理
6.4 版本兼容性处理方案
| 兼容性维度 | 处理方案 |
|---|---|
| Python 版本 | 脚本应兼容 Python 3.8+,避免使用 3.9+ 特性(如 dict 合并运算符 |) |
| 白名单模块变更 | 后端升级白名单时,旧脚本仍可运行(白名单只增不减) |
| 工作流版本 | 脚本节点配置存储在节点 config 中,工作流版本快照会完整保存脚本内容 |
| 前端兼容性 | 节点类型 'script' 为新增枚举值,不影响旧工作流加载与执行 |
7. 附录
7.1 API 参考手册
7.1.1 测试执行 API
端点:POST /api/v1/workflows/<workflow_id>/nodes/script/test
权限:需要工作流的编辑权限(_check_base_edit_permission)
请求体:
{
  "language": "python",
  "script_source": "set_result(input)",
  "sample_input": {"key": "value"},
  "timeout": 30
}| 参数 | 类型 | 必填 | 默认值 | 说明 |
|---|---|---|---|---|
language | string | 是 | - | "python" |
script_source | string | 是 | - | 脚本源代码 |
sample_input | any | 否 | null | 模拟的上游输入数据 |
timeout | number | 否 | 30 | 超时秒数(1-300) |
响应体:
{
  "status": "success",
  "result": {"key": "value"},
  "branch": null,
  "error": null,
  "duration_ms": 25,
  "stdout": ""
}| 字段 | 类型 | 说明 |
|---|---|---|
status | string | "success" 或 "error" |
result | any | 脚本输出结果(成功时) |
branch | string | null | 分支标签(若调用了 set_branch) |
error | string | null | 错误信息(失败时,含 traceback) |
duration_ms | number | 执行耗时(毫秒) |
stdout | string | 脚本标准输出(截断至 5000 字符) |
特性:
- 不持久化、不产生工作流实例与执行日志
context为最小上下文(仅包含sample_input相关数据)- stdout 截断至 5000 字符
7.1.2 脚本执行服务 API(内部)
调用方式:ScriptExecutionService.execute(...)
from app.services.script_execution_service import ScriptExecutionService

result = ScriptExecutionService.execute(
    language='python',
    script_source='set_result(input)',
    input_data={'key': 'value'},
    context={'trigger': {}, 'record': {}, 'instance': {}, 'workflow': {}, 'loop': None, 'node_outputs': {}},
    timeout=30
)返回结构:同测试执行 API 响应体。
7.2 常见错误码说明
| 错误信息 | HTTP 状态码 | 原因 | 解决方案 |
|---|---|---|---|
脚本语言必须为 'python' | 400 | language 字段值非法 | 检查 language 字段 |
脚本内容不能为空 | 400 | script_source 为空字符串 | 填写脚本代码 |
脚本内容不能超过 50000 字符 | 400 | 脚本过长 | 拆分为多个节点或精简代码 |
超时时间必须为 1-300 之间的正整数 | 400 | timeout 超出范围 | 调整为 1-300 的整数 |
结果变量名必须为字母数字下划线... | 400 | result_variable 格式非法 | 使用合法变量名 |
分支标签重复: xxx | 400 | branches 中 label 重复 | 确保标签唯一 |
分支 xxx 的目标节点不存在: yyy | 400 | target_node_id 不存在 | 检查目标节点 ID |
脚本执行超时(30秒) | - | 脚本执行超过 timeout | 优化算法或增加 timeout |
脚本输出超过 1MB 限制 | - | 结果序列化超过 1MB | 精简输出数据 |
脚本输出无法 JSON 序列化 | - | 返回了非 JSON 类型 | 只返回基本类型 |
模块 'xxx' 被禁止导入 | - | 导入了非白名单模块 | 仅使用白名单模块 |
NameError: name 'open' is not defined | - | 调用了被禁用的内建函数 | 改用白名单模块 |
7.3 工具链与生态集成说明
7.3.1 前端依赖
| 依赖包 | 版本 | 用途 |
|---|---|---|
codemirror | 6.x | 代码编辑器核心 |
@codemirror/lang-python | 6.x | Python 语法支持 |
@codemirror/lint | 6.x | 基础错误提示(lint gutter) |
vue-codemirror | 6.x | Vue 3 集成 CodeMirror |
7.3.2 后端依赖
| 依赖 | 版本 | 用途 |
|---|---|---|
| Python | ≥ 3.8 | Python 脚本执行 |
7.3.3 与其他节点的集成关系
┌──────────────┐     ┌──────────────┐     ┌──────────────┐
│  find_records │ ──→ │    script    │ ──→ │ update_record│
│  (数据源)     │     │  (转换处理)  │     │  (写回)      │
└──────────────┘     └──────────────┘     └──────────────┘
                            ↓
                     ┌──────────────┐
                     │  send_email  │
                     │  (通知)      │
                     └──────────────┘
                            ↓
                     ┌──────────────┐
                     │   webhook    │
                     │  (外部调用)  │
                     └──────────────┘
                            ↓
                     ┌──────────────┐
                     │  condition   │
                     │  (条件分支)  │
└──────────────┘| 集成节点 | 数据流向 | 引用方式 |
|---|---|---|
| find_records → script | 查询结果作为 input | 自动注入或通过 input_node_id 指定 |
| script → update_record | 脚本输出作为更新值 | {{script_result.field}} 或 {{node_outputs.<id>.result.field}} |
| script → send_email | 脚本输出作为邮件内容 | {{script_result.field}} |
| script → webhook | 脚本输出作为请求体 | {{script_result.field}} |
| script → condition | 脚本输出作为条件判断依据 | {{script_result.field}} |
| loop → script | 循环当前数据作为 context.loop.current_data | 脚本内读取 context['loop'] |
7.3.4 数据库迁移
新增 'script' 节点类型涉及的数据库迁移:
- 迁移文件:
migrations/versions/20260801_0022_add_script_node_type.py - 兼容性:PostgreSQL 使用
ALTER TYPE ... ADD VALUE,SQLite 使用op.batch_alter_table(recreate='always') - 影响:
workflow_nodes.node_type枚举扩展,不影响现有数据
7.3.5 测试套件
| 测试文件 | 测试内容 | 测试数量 |
|---|---|---|
tests/test_script_execution_service.py | Python 沙箱单元测试 | 8 |
tests/test_script_node_validation.py | 节点配置校验测试 | 8 |
tests/test_script_node_integration.py | 执行引擎集成测试 | 15 |
src/components/workflow/__tests__/WorkflowNodeConfig.script.spec.ts | 前端配置面板测试 | 10 |
src/utils/__tests__/workflowNodeType.spec.ts | 节点注册表测试 | 10 |
src/services/api/__tests__/workflowApiService.spec.ts | API 服务测试 | 22 |
附录:如何获取节点 ID 与字段 ID
工作流模板变量(如 {{node_outputs.<节点ID>.result.field}}、{{record.<字段ID>}})都以节点 ID 或字段 ID 作为引用键。配置界面已在多处直接展示这些 ID,并支持点击复制,无需再通过抓包或查看 DOM 获取。
A.1 节点 ID
- 在工作流画布的节点卡片右下角,节点类型标签旁以小号等宽字体显示当前节点的 ID(形如
node_xxx)。 - 将鼠标悬停其上即可看到完整 ID;点击该 ID 即可复制到剪贴板。
- 在脚本节点的「输入来源」「分支路由」、更新/创建记录的字段映射等下拉选项中,选项文案统一为
节点名称(节点类型 · 节点ID),可直接复制所需节点的 ID。
A.2 字段 ID
- 在字段管理对话框的字段列表中,每个字段名称右侧以小号等宽字体显示该字段的 ID(形如
fld_xxx)。 - 点击该 ID 即可复制;用于模板变量
{{record.<字段ID>}}时直接粘贴即可。 - 在工作流节点的字段下拉选项中,选项文案统一为
字段名称(字段ID),便于直接复制。
A.3 可复制的模板变量语法
在更新记录、创建记录、发送邮件、Webhook 等节点的模板输入框下方,界面会列出当前上下文可用的变量引用语法(如 {{record.<字段ID>}}、{{node_outputs.<节点ID>.result}}、{{loop.item}}),点击任意一条即可复制完整语法,粘贴到模板中后再替换为真实 ID。
提示:循环体子节点中还会通过「插入循环变量」按钮提供
{{loop.current_data.<字段ID>}}等片段,其中的字段下拉同样展示字段 ID。